前置知识
- 高斯分布:知道 μ 和 σ² 分别控制什么,多维高斯长什么样
- 条件概率与贝叶斯公式:因为 encoder 学的就是后验分布 q(z|x)
- KL 散度:衡量两个分布差异的指标,VAE 损失函数的第二项。至少要理解它的直觉意义(不对称、非负、越接近越小)
- 从分布中采样的概念:理解”采样不可导”这个问题,才能明白重参数化技巧为什么存在
- (进阶)最大似然估计:理解”生成模型在做什么”的理论根基
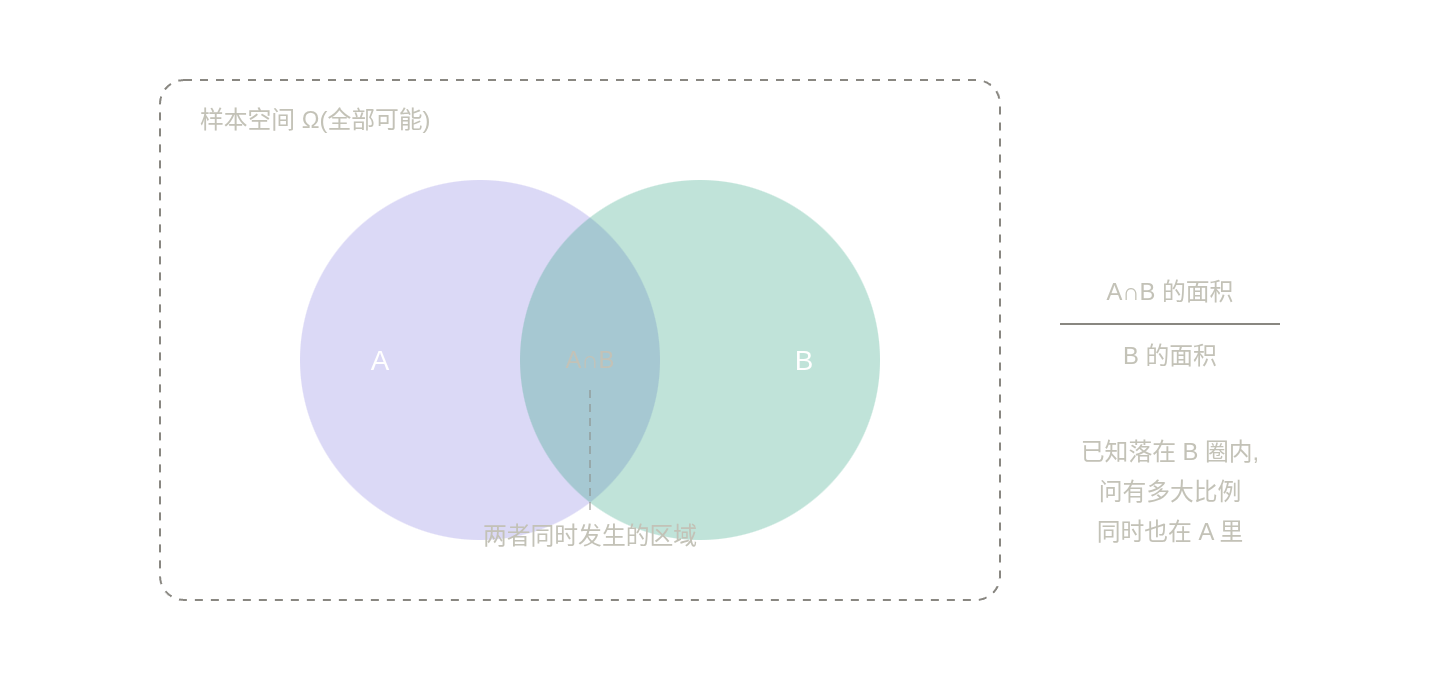
P(A∩B)=P(A∣B)P(B)=P(B∣A)P(A)
P(A∣B)=P(B)P(B∣A)P(A)
P(B)=∑iP(B∣Ai)P(Ai)
P(Ai∣B)=∑jP(B∣Aj)P(Aj)P(B∣Ai)P(Ai)
p(z∣x)=p(x)p(x∣z)p(z),p(x)=∫p(x∣z)p(z)dz