VAE(变分自编码器 Variational Auto-Encoder)
次阅读
VAE(变分自编码器 Variational Auto-Encoder)
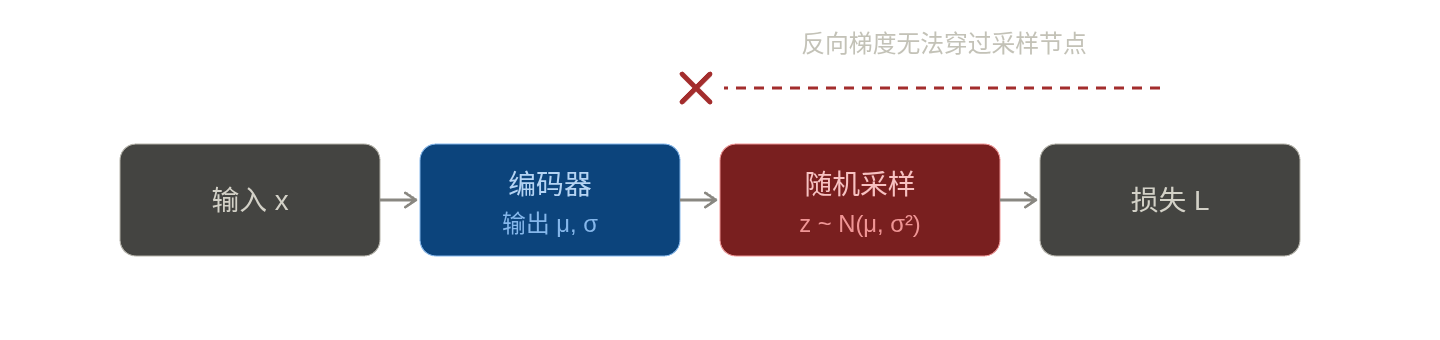
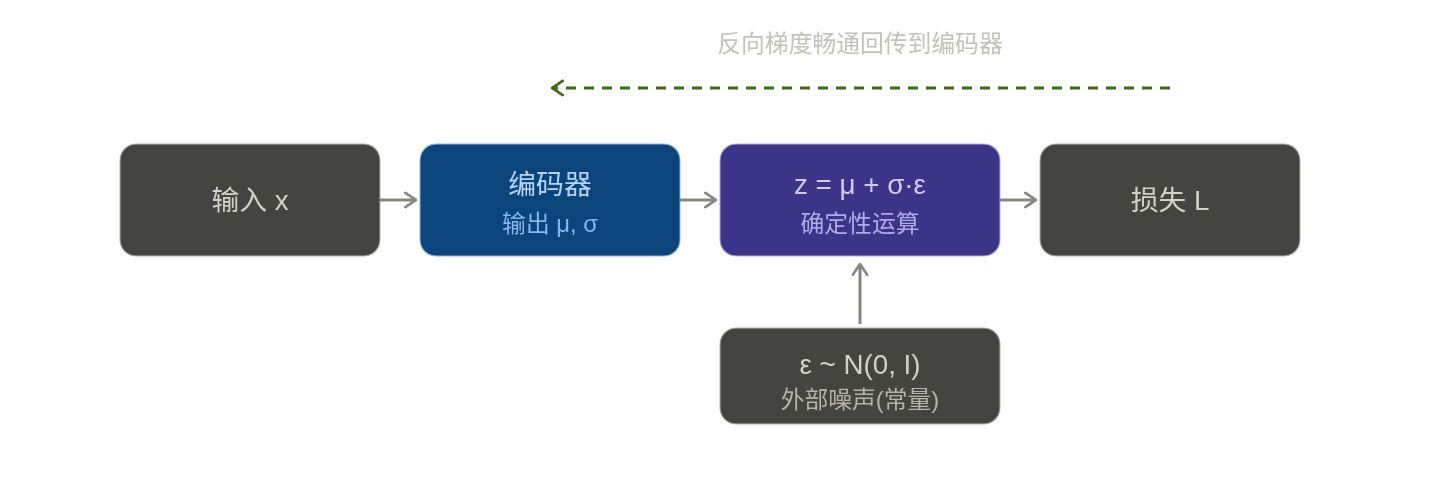
                     训练时 ACT 的输入 → Transformer Encoder 序列的构建
═══════════════════════════════════════════════════════════════════════════════

  输入 batch:
  ┌─────────────────┐  ┌─────────────────┐  ┌──────────┐  ┌──────────────────┐
  │ cam1 图像        │  │ cam2 图像        │  │ 机器人状态 │  │ 真实动作(VAE用)   │
  │ (B, 3, H, W)    │  │ (B, 3, H, W)    │  │ (B, 7)   │  │ (B, chunk, 7)    │
  └────────┬────────┘  └────────┬────────┘  └────┬─────┘  └────────┬─────────┘
           │                    │                │                 │
           ▼                    ▼                │                 ▼
    ┌────────────┐        ┌────────────┐         │          ┌────────────┐
    │  ResNet    │        │  ResNet    │         │          │ VAE Encoder│
    │ backbone   │◄──────►│ backbone   │         │          │  → 隐变量 z │
    │(权重共享!)  │ 同一个  │(权重共享!)  │        │          └──────┬─────┘
    └─────┬──────┘        └─────┬──────┘         │                 │
          │                     │                │                 │
   特征图(B,C',H',W')     特征图(B,C',H',W')      │                 │
          │                     │                │                 │
   展平 h×w → token       展平 h×w → token        │                 │
          │                     │                │                 │
          ▼                     ▼                ▼                 ▼
     ┌─────────┐          ┌─────────┐        ┌──────┐         ┌──────┐
     │H'*W' 个 │          │H'*W' 个 │        │1 个   │        │1 个   │
     │ token   │          │ token   │        │token │         │token │
     └────┬────┘          └────┬────┘        └──┬───┘         └──┬───┘
          │                    │                │                │
          └──────────┬─────────┴────────────────┴────────────────┘
                     │
                     ▼   沿"序列长度"方向全部拼在一起 (extend/stack)
  ┌───────────────────────────────────────────────────────────────────────┐
  │  z │ state │ [cam1: t1 t2 t3 ... t_(H'W')] │ [cam2: t1 t2 ... t_(H'W')] │
  └───────────────────────────────────────────────────────────────────────┘
        └──────────────────────── 一个长 token 序列 ─────────────────────────┘
                     │
                     ▼
        ┌────────────────────────────┐
        │   Transformer Encoder      │   self-attention:
        │   (self-attention)         │   每个 token 关注所有其他 token
        │                            │   → cam1 与 cam2 的特征在这里融合
        └─────────────┬──────────────┘
                      │
                      ▼
        ┌────────────────────────────┐
        │   Transformer Decoder      │
        │   → action_head            │
        └─────────────┬──────────────┘
                      ▼
              预测动作 (B, chunk, 7)